
什麼是 GLM-5.3-Flash?功能、基準測試、定價與 API 指南
 2026-10-07
 1206 次閱讀
GLM-5.3-Flash 是由 Z.ai 開發、以效率為核心的原生多模態模型。它專為程式開發代理、視覺理解、長上下文任務、文件工作流程及工具使用而設計,同時將推論成本控制在大型旗艦模型之下。
此模型共有 3,200 億個參數,但每個權杖僅啟用 180 億個參數。其混合專家(Mixture-of-Experts)設計會讓大多數參數在處理每個權杖時保持未啟用狀態,從而減少推論所需的運算量。它也採用結合稀疏注意力與線性注意力的混合式架構,協助模型更有效率地處理長上下文。
透過 ApiSmart,開發者可以使用與 OpenAI 相容的 API 存取 GLM-5.3-Flash,並在同一個平台上將它與其他支援的 AI 模型整合使用。
GLM-5.3-Flash 快速總覽
GLM-5.3-Flash 是 GLM-5 系列中第一個原生多模態模型。它不只是 GLM-5.3 的較小型量化或蒸餾版本,而是以全新的多模態基礎模型進行訓練,並從架構設計階段就將效率納入考量。
其主要特點包括:
|
規格 |
GLM-5.3-Flash |
|
開發者 |
Z.ai |
|
模型架構 |
多模態混合專家模型 |
|
總參數量 |
3,200 億 |
|
啟用參數量 |
每個權杖 180 億 |
|
ApiSmart 上下文長度 |
最多 100 萬個權杖 |
|
ApiSmart 最大輸出量 |
最多 65,536 個權杖 |
|
支援的輸入格式 |
文字與圖片 |
|
輸出格式 |
文字 |
|
注意力設計 |
稀疏與線性混合注意力 |
|
推理層級 |
低、高、最高 |
|
開放權重 |
是 |
|
授權條款 |
MIT |
|
ApiSmart 模型名稱 |
請在 ApiSmart 控制台確認確切的模型 ID |
ApiSmart 目前列出的 GLM-5.3-Flash 具備 100 萬個權杖的上下文視窗,並採用隨用隨付的計費方式。
GLM-5.3-Flash 如何運作?
混合專家架構
GLM-5.3-Flash 採用混合專家(MoE)架構。模型不會針對每次請求啟用所有參數,而是在推論期間選擇一小組相關參數。
雖然此模型共有 3,200 億個參數,但每個權杖只會啟用約 180 億個參數。這能減少處理每個權杖所需的運算量,同時仍可運用大型模型的整體容量。
此設計旨在平衡以下三點:
- 強大的推理與程式開發效能
- 較低的運算成本
- 有效率地處理高流量工作負載
稀疏與線性混合注意力
隨著輸入內容增加,傳統注意力機制的成本會越來越高。GLM-5.3-Flash 透過結合稀疏注意力與線性注意力來因應這項挑戰。
線性注意力能有效率地處理局部關係,而稀疏注意力則會辨識並擷取長上下文其他部分的重要資訊。兩種注意力方法相互配合,能協助模型處理大型程式碼儲存庫、長篇文件及延續時間較長的代理歷程,而不必在所有位置都採用成本最高的注意力運算。
Z.ai 也採用流形約束超連接(MHC)來提升擴展效率。此模型使用包含 30 兆個權杖的多模態語料庫進行訓練。
原生多模態理解
GLM-5.3-Flash 可以在同一個工作流程中處理文字與視覺資訊,因此其用途不僅限於簡單的圖片描述。
例如,AI 代理可以:
- 檢查螢幕截圖或算繪完成的介面。
- 找出版面配置、樣式或功能方面的問題。
- 修改底層程式碼。
- 算繪更新後的結果。
- 檢查新版本並持續改進。
這類視覺回饋適用於前端開發、瀏覽器自動化、文件審查,以及其他需要模型檢查自身工作成果的任務。
GLM-5.3-Flash 基準測試表現
根據 Z.ai 公布的結果,GLM-5.3-Flash 在多項程式開發及代理相關評測中的表現均較 GLM-5.2 大幅提升。
|
基準測試 |
GLM-5.3-Flash |
GLM-5.2 |
Claude Opus 4.8 |
|
Terminal-Bench 2.1 |
84.3 |
81.0 |
85.0 |
|
DeepSWE v1.1 |
63.4 |
46.2 |
58.0 |
|
Toolathlon Verified |
78.4 |
59.9 |
76.2 |
|
AutomationBench |
48.8 |
26.2 |
41.0 |
|
Agents’ Last Exam |
26.3 |
20.4 |
27.0 |
|
HLE with Tools |
55.3 |
54.7 |
57.9 |
|
GDPval-AA v2 |
1773 |
1504 |
1582 |
這些結果顯示,此模型在軟體工程、工具使用及多步驟自動化方面表現強勁。不過,基準測試結果不應被視為適用於所有情境的排名。代理框架、工具設定、時間限制及上下文管理方式,都可能影響實際使用時的表現。
因此,團隊在決定部署之前,應使用具代表性的提示詞及正式環境工作負載來測試模型。
GLM-5.3-Flash、GLM-5.3 與 GLM-5.2 比較
這三個模型各自著重於不同需求。
|
類別 |
GLM-5.3-Flash |
GLM-5.3 |
GLM-5.2 |
|
主要重點 |
效率與多模態能力 |
最強大的模型能力 |
成熟的程式開發與代理工作流程 |
|
原生多模態輸入 |
是 |
並非此版本的主要重點 |
並非此版本的主要重點 |
|
架構重點 |
稀疏與線性混合注意力 |
高效能旗艦架構 |
長時間程式開發與代理任務 |
|
最適合的用途 |
高流量多模態應用程式 |
需要最高推理品質的任務 |
現有的 GLM 系統 |
|
開放權重 |
是 |
是 |
是 |
如果最高等級的推理或軟體工程品質比成本更重要,GLM-5.3 可能是較好的選擇。若更重視多模態輸入、長上下文及較低的推論成本,GLM-5.3-Flash 則更為合適。
GLM-5.3-Flash API 定價
ApiSmart 目前列出的 GLM-5.3-Flash 費率如下:
|
使用項目 |
Z.ai 標準價格 |
ApiSmart 價格 |
|
輸入權杖 |
每 100 萬個權杖 $0.15 |
每 100 萬個權杖 $0.09 |
|
快取輸入 |
每 100 萬個權杖 $0.03 |
每 100 萬個權杖 $0.018 |
|
輸出權杖 |
每 100 萬個權杖 $0.50 |
每 100 萬個權杖 $0.30 |
根據這些已公布的費率,截至本文撰寫時,ApiSmart 的標示價格約比 Z.ai 的標準 API 價格低 40%。價格可能會有所變動,因此開發者在計算正式環境預算之前,應先查看 ApiSmart 模型清單。
對於包含大型提示詞、重複工具呼叫、大量文件處理或高請求量的工作負載而言,這項價差會更加顯著。
GLM-5.3-Flash 可以用來做什麼?
程式開發代理
GLM-5.3-Flash 能協助代理檢查程式碼儲存庫、產生程式碼、診斷錯誤、操作終端機工具,以及完成多步驟開發任務。
常見用途包括程式開發助理、自動偵錯、程式碼審查、儲存庫遷移、測試產生及內部開發工具。
視覺化前端開發
由於此模型支援視覺輸入,因此可以分析螢幕截圖,並與算繪完成的介面進行比較。它能協助找出間距、字型排印、色彩、元件位置及響應式顯示行為等方面的差異。因此,它很適合用於從螢幕截圖產生程式碼的工具,以及會反覆檢查並改善算繪介面的前端代理。
瀏覽器與電腦自動化
代理可以透過螢幕截圖了解網站或軟體介面的目前狀態,判斷適當的操作,並在完成操作後檢查結果。
可能的工作流程包括瀏覽器研究、表單處理、內部行政工作及軟體測試。
文件分析與製作
此模型可支援涉及報告、簡報、試算表及其他專業文件的工作流程。視覺理解能力有助於找出僅靠擷取文字難以察覺的版面問題,包括內容溢出、對齊方式不一致及元素重疊等情況。
研究與資料分析
GLM-5.3-Flash 的長上下文能力,使其適合處理大量報告、研究資料、財務揭露文件及技術文件。
此模型能協助整理證據、比較來源及建立結構化摘要。若用於專業研究,其結論仍應與原始來源相互核對。
客戶支援與知識系統
企業可以將 GLM-5.3-Flash 連接至說明文件、產品資訊或內部知識庫,建立能夠處理長篇對話與複雜使用者問題的客服助理。
開放權重與自行託管
GLM-5.3-Flash 採用 MIT 授權條款,其權重可從 Hugging Face 下載。Z.ai 列出的支援部署框架包括 SGLang、vLLM、Transformers、TokenSpeed、KTransformers 及 Unsloth。
不過,開放權重不代表部署過程一定很簡單。一個約有 3,200 億個參數的模型,需要大量儲存空間、加速器記憶體及推論基礎架構。
自行託管較適合需要完全掌控基礎架構、進行私有部署或自訂模型,或已具備分散式推論系統的團隊。對於沒有這類基礎架構的開發團隊,使用託管式 API 可省去管理 GPU、分散式服務、擴展、監控及模型更新等工作。
如何透過 ApiSmart 存取 GLM-5.3-Flash
ApiSmart 透過與 OpenAI 相容的 API 提供支援的模型。如果您的應用程式已使用 OpenAI SDK,主要只需要變更 API 金鑰、基礎 URL 及模型 ID。
步驟 1:建立 ApiSmart 帳戶
前往 ApiSmart.ai 並建立帳戶。
登入後:
- 產生 API 金鑰。
- 開啟模型清單。
- 找到 GLM-5.3-Flash。
- 複製控制台顯示的模型 ID。
- 為帳戶加值足夠的餘額,以供測試或正式環境使用。
API 金鑰應儲存在環境變數或安全的機密管理系統中,絕不應暴露在前端程式碼或公開的程式碼儲存庫內。
步驟 2:使用 Python 呼叫 GLM-5.3-Flash
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APISMART_API_KEY",
    base_url="https://api.apismart.ai/v1"
)

response = client.chat.completions.create(
    model="GLM-5.3-FLASH",
    messages=[
        {
            "role": "user",
            "content": "建立一份將 Python REST API 遷移至非同步架構的技術計畫。"
        }
    ]
)

print(response.choices[0].message.content)
部署前,請在 ApiSmart 控制台確認確切的大小寫及模型識別碼。
步驟 3:使用 cURL 呼叫 API
curl https://api.apismart.ai/v1/chat/completions \
  -H "Authorization: Bearer YOUR_APISMART_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-FLASH",
    "messages": [
      {
        "role": "user",
        "content": "分析這個軟體架構,並找出可能影響擴展能力的瓶頸。"
      }
    ]
  }'
控制推理強度
GLM-5.3-Flash 支援三種推理強度設定:low、high、max 。
官方模型說明指出,預設使用 max。當速度較重要時可使用較低的設定;面對難度較高的程式開發、規劃或分析任務時,則可使用 high 或 max。
將此參數加入正式環境的請求之前,請先在 ApiSmart 說明文件中確認支援的請求格式。
為什麼要透過 ApiSmart 使用 GLM-5.3-Flash?
一個 API 存取多種模型
ApiSmart 讓開發者能透過單一平台存取支援的語言、圖片及影片模型。團隊可以測試不同的支援模型,不必為每個供應商分別建立整合介面。
與 OpenAI 相容的整合方式
已使用 OpenAI 相容用戶端建立的應用程式,只要變更 API 端點、API 金鑰及模型名稱即可連線。這能讓模型測試與遷移更加簡單。
智慧路由與自動容錯移轉
ApiSmart 會根據可用性、延遲及價格等因素提供智慧路由,也支援自動容錯移轉、斷路器及重試機制,讓個別供應商發生問題時,應用程式仍能持續運作。
集中管理使用情況
API 金鑰、使用量、成本及日誌都能透過單一平台管理,不必分散在多個供應商帳戶中。
安全性與可靠性
ApiSmart 表示,其針對請求內容提供零資料保留、稽核功能、全球加速及 99.99% 可用性服務水準協議(SLA)。各組織應檢視適用的服務協議與安全性文件,確認這些控管措施符合自身的法規遵循需求。
GLM-5.3-Flash 適合您的應用程式嗎?
如果應用程式需要高效率的程式開發能力、多模態輸入、長上下文、高請求量或開放權重部署,GLM-5.3-Flash 值得一試。
如果最重要的需求是最高等級的推理品質,而推論成本居於次要考量,大型旗艦模型可能仍是較好的選擇。
最佳做法是使用相同的提示詞、工具及評估標準測試多種模型。開發者應比較回應品質、延遲、可靠性及總成本,而不應只根據單一基準測試來選擇模型。
結語
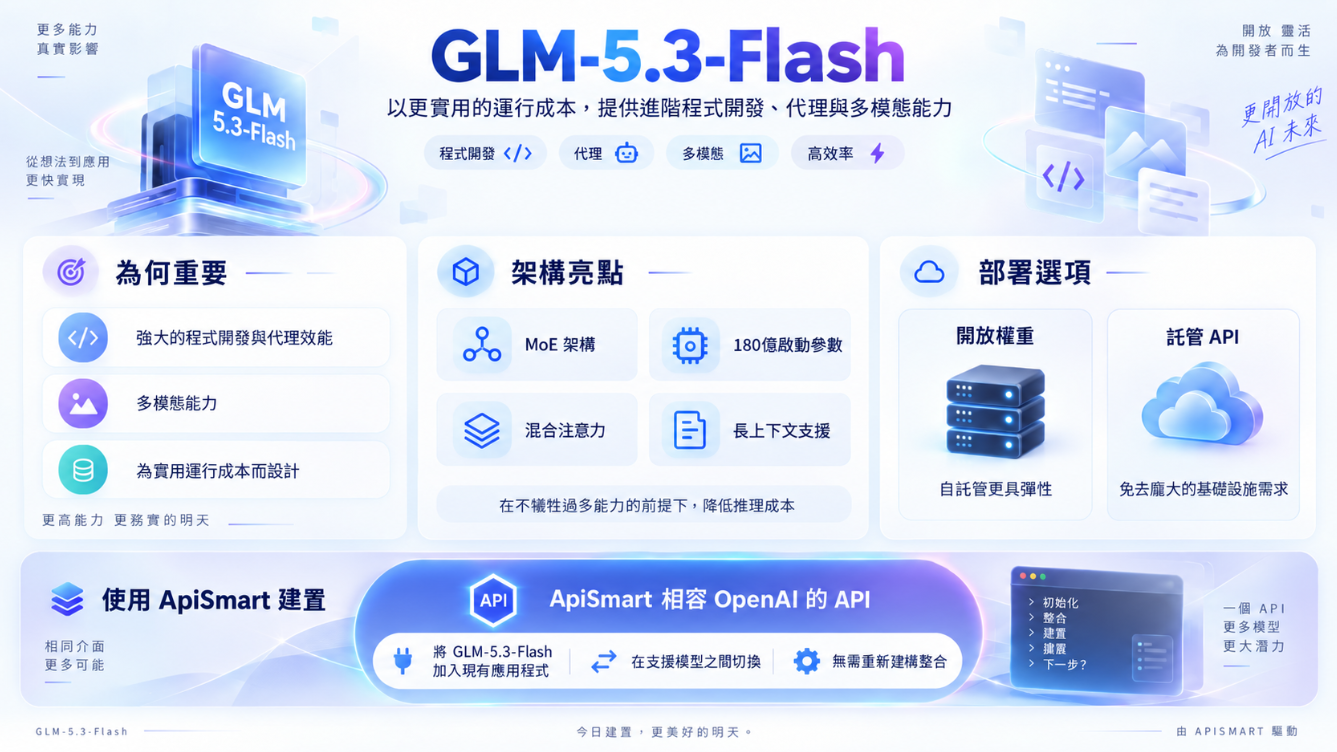
GLM-5.3-Flash 旨在以更實際的營運成本,提供先進的程式開發、代理及多模態能力。其 MoE 架構、180 億個啟用參數、混合注意力及長上下文支援,都是為了在不過度犧牲能力的情況下降低推論成本。開放權重提供了自行託管的彈性,而託管式 API 則能避免部署如此規模模型所需的大量基礎架構。
透過 ApiSmart 與 OpenAI 相容的 API,開發者可以將 GLM-5.3-Flash 加入現有應用程式,並在支援的模型之間切換,而不必重新建立整合介面。
常見問題
什麼是 GLM-5.3-Flash?
GLM-5.3-Flash 是 Z.ai 在 GLM-5 系列推出的第一個原生多模態模型,專為高效率程式開發、視覺理解、長上下文處理及 AI 代理工作流程而設計。
GLM-5.3-Flash 是開放原始碼嗎?
更精確的說法是「開放權重」。其模型權重依 MIT 授權條款發布,允許在本機部署及廣泛重複使用。
GLM-5.3-Flash 有多少參數?
此模型共有 3,200 億個參數,每個權杖會啟用約 180 億個參數。
GLM-5.3-Flash 支援圖片嗎?
支援。這是一個原生多模態模型,可接收文字與圖片輸入,並產生文字回應。
GLM-5.3-Flash 適合用於程式開發代理嗎?
適用。它專為程式開發、工具使用及長時間運作的代理工作流程而設計。不過,團隊在正式部署之前,仍應搭配自己的工具及開發環境進行測試。
在 ApiSmart 上使用 GLM-5.3-Flash 的費用是多少?
截至 2026 年 9 月 15 日,ApiSmart 列出的價格為:輸入權杖每 100 萬個 $0.09、快取輸入每 100 萬個 $0.018,以及輸出權杖每 100 萬個 $0.30。
部署前請查看 ApiSmart 定價頁面,以取得最新費率。
我可以透過 OpenAI SDK 使用 GLM-5.3-Flash 嗎?
可以。ApiSmart 提供與 OpenAI 相容的介面,開發者可以使用 ApiSmart 的基礎 URL、API 金鑰及模型識別碼來設定 OpenAI SDK。
GLM-5.3-Flash 可以部署在本機嗎?
可以,但其龐大的模型規模需要相當可觀的儲存空間、加速器記憶體及分散式推論基礎架構。對於尚未建置大規模 GPU 系統的團隊,使用託管式 API 可能更為實際。