
該使用 DeepSeek V4 Pro 嗎?正式環境評估指南
 2026-10-07
 2003 次閱讀
一款擁有 1.6 兆個參數及 100 萬 token 上下文視窗的模型,很容易令人印象深刻;但要判斷它是否能改善正式環境系統,則困難得多。
DeepSeek V4 Pro 的啟用容量遠高於 DeepSeek V4 Flash。這些額外容量可以改善複雜程式設計、技術推理及長時間執行的代理工作流程。然而,若將它指派給較小模型就能完成的任務,也可能增加延遲、上下文成本及基礎設施需求。
因此,真正有用的問題不是:
DeepSeek V4 Pro 強大嗎?
更實際的問題是:
哪些請求能產生足夠的額外價值,值得將它們分流至 DeepSeek V4 Pro?
對大多數應用程式而言,將 V4 Pro 作為升級處理模型,比設為每項請求的預設模型更合理。一般工作可先交由速度較快的模型,將 V4 Pro 保留給困難任務、先前失敗的嘗試,或錯誤風險較高的情況。
30 秒快速決策
當請求涉及下列情況時,使用 DeepSeek V4 Pro:
- 大型或不熟悉的儲存庫
- 多個相互依賴的推理步驟
- 跨檔案除錯
- 長篇技術文件
- 複雜限制條件
- 長時間的工具型執行
- 高昂的失敗成本
- 需要更深入的規劃
當請求涉及下列情況時,使用較輕量的模型:
- 分類
- 簡單擷取
- 短篇摘要
- 基礎問答
- 一般改寫
- 直接的程式碼補全
- 大量、低風險流量
- 嚴格的延遲要求
這項差異很重要,因為 DeepSeek V4 Pro 共有 1.6T 個參數,每個 token 啟用 49B;V4 Flash 則共有 284B 個參數,每個 token 啟用 13B。兩者皆支援 100 萬 token 的上下文視窗。
將 DeepSeek V4 Pro 作為正式環境元件
DeepSeek V4 Pro 最適合作為大型系統的一部分,而非整套 AI 技術堆疊。
該系統還可能包含:
- 請求分類器
- 檢索層
- 成本較低的預設模型
- 工具定義
- 程式碼執行
- 輸出驗證器
- 重試規則
- 備援模型
- 人工審查
- 用量監控
模型本身不會決定修補程式是否安全、計算是否正確,或面向客戶的回答是否符合政策。這些決策應由周邊應用程式負責。
因此,有效的測試並非確認 V4 Pro 能否給出令人驚豔的回答,而是它能否協助完整工作流程更常取得正確且經過驗證的結果。
正式環境導向的規格摘要
|
決策因素 |
DeepSeek V4 Pro |
|
目前的 ApiSmart 路由 |
DeepSeek-V4-Pro-0813 |
|
架構 |
稀疏混合專家模型 |
|
總參數量 |
1.6T |
|
啟用參數量 |
每個 token 49B |
|
上下文視窗 |
目前 ApiSmart 清單為 1,024K |
|
ApiSmart 最大輸出 |
256K |
|
原生輸入 |
文字 |
|
推理選項 |
Non-think、Think High 及 Think Max |
|
開放權重 |
是 |
|
授權 |
MIT |
|
建議角色 |
高能力或升級處理層級 |
DeepSeek 的模型卡確認了 1.6T/49B 架構及百萬 token 上下文。ApiSmart 目前的清單則指出 DeepSeek-V4-Pro-0813 具備 1,024K 上下文視窗及 256K 最大輸出。
請勿混用不同部署的限制。若使用 ApiSmart,應採用目前 ApiSmart 路由所顯示的限制。
五種足以採用 V4 Pro 的工作負載
1. 整個儲存庫的除錯
當必要資訊位於同一個檔案時,許多程式設計模型都能有良好表現,但正式環境中的錯誤很少如此單純。
儲存庫層級問題可能涉及:
- 驗證中介軟體
- 設定
- 資料庫狀態
- 快取
- 型別定義
- 測試
- 部署設定
- 最近的相依套件變更
當代理必須先追蹤多個元件之間的行為,才能進行變更時,V4 Pro 值得測試。
良好的儲存庫測試應要求模型:
- 檢查專案。
- 找出失敗路徑。
- 說明根本原因。
- 提出最小且安全的變更。
- 執行針對性測試。
- 執行更完整的測試套件。
- 回報仍存在的不確定性。
模型不應只因產生看似合理的修補程式就獲得肯定。
2. 從需求到實作的工作
有些開發任務始於長篇規格,而非明確定義的錯誤。
模型可能需要串聯:
- 產品需求
- 現有架構
- 資料契約
- 安全規則
- 相容性限制
- 測試需求
- 發行文件
當成功與否取決於規劃及實作過程中能否持續遵守所有限制時,V4 Pro 更具價值。
3. 長週期代理
只執行一次工具呼叫的代理相對容易評估;執行一小時的代理則可能以更多方式失敗。
長週期的失敗模式包括:
- 忘記原始目標
- 重複執行失敗的指令
- 編輯不相關的檔案
- 忽略驗收條件
- 完成後仍持續執行
- 累積彼此矛盾的假設
- 不必要地擴大工作範圍
請在這些失敗確實可能發生的工作流程中測試 V4 Pro。真正的問題是它能否在許多操作之間維持連貫計畫,而非只是能否寫出更好的文字。
4. 大型文件綜合分析
100 萬 token 的上下文可以容納大量文件集合,但容量本身並不足夠。
模型仍必須:
- 找出相關段落
- 區分事實與解讀
- 解決衝突
- 保留日期與實體資訊
- 引用支持證據
- 避免捏造缺少的資訊
V4 Pro 值得用於技術盡職調查、政策比較、研究綜整及大型文件審查,尤其適合已將檢索與引用檢查納入工作流程的情況。
5. 高成本決策
當一項錯誤會造成大量後續工作時,較強大的模型反而可能更經濟。
例如:
- 影響多項服務的移轉計畫
- 涉及安全性的程式碼變更
- 資料庫綱要更新
- 複雜的財務計算
- 企業架構決策
- 阻礙版本發布的缺陷
重要指標不是單次請求的價格,而是取得通過驗收結果的總成本。
三種通常不需要 V4 Pro 的工作負載
分類與路由
意圖分類、語言偵測及簡單工單路由通常只需有限的推理。較小的模型往往能更快、以更低成本完成這些任務。
可預測的擷取
若輸入格式穩定且輸出綱要範圍狹窄,額外的模型容量可能無法產生實質價值。
應使用綱要驗證及重試邏輯,而非將每項擷取請求都交給最大的模型。
短篇、低風險生成
產品說明、基礎改寫及一般摘要通常無法從 V4 Pro 獲得足以讓它成為預設模型的效益。
例外情況是這些任務包含困難的法規遵循或事實要求。
100 萬 token 並非提示詞目標
大型上下文視窗是容量上限,不代表建議每次請求都填滿。
傳送整個儲存庫或文件封存庫可能導致:
- 更高的輸入成本
- 更長的首個 token 回應時間
- 更多無關資訊
- 相互衝突的版本
- 對關鍵證據的注意力降低
- 評估更難重現
更好的問題是:
能讓模型取得足夠證據完成任務的最小上下文為何?
設計良好的長上下文管線可以使用:
- 中繼資料篩選
- 檢索
- 儲存庫對應表
- 相依關係分析
- 上下文排序
- 重複資料刪除
- 使用 V4 Pro 進行最終推理
任務需要時隨時可以增加上下文,不必讓每項請求預設都非常龐大。
如何正確評估 V4 Pro
公開基準測試可以找出候選模型,但無法判斷 V4 Pro 是否適合特定產品。DeepSeek 公布的 V4-Pro-Max 結果相當優異,包括 LiveCodeBench 93.5%,以及在其評估設定下 SWE-bench Verified 的問題解決率達 80.6%。模型卡也顯示,結果會因推理模式及基準測試而異。請使用取自實際應用程式的任務進行測試。
步驟 1:定義驗收測試
每項任務都需要可衡量的結果。
|
工作負載 |
驗收條件 |
|
儲存庫修復 |
完整測試套件通過 |
|
資料擷取 |
輸出通過綱要及欄位驗證 |
|
研究綜整 |
每項事實陳述都能對應到所提供的證據 |
|
工具代理 |
在工具及重試限制內完成目標 |
|
安全審查 |
發現經工具或合格審查人員確認 |
|
規劃 |
計畫符合所有記錄的限制條件 |
若沒有驗收測試,評估人員往往會獎勵自信的文字,而非正確的工作成果。
步驟 2:使用具代表性的任務
建立一組來自真實應用程式流量的任務。
包括:
- 一般任務
- 困難任務
- 模糊任務
- 缺少資訊的請求
- 應拒絕或升級處理的任務
- 曾造成失敗的案例
只包含展示型提示詞的資料集,會高估正式環境品質。
步驟 3:固定環境
每款候選模型都應接收相同的:
- 儲存庫快照
- 系統指令
- 工具
- 網路存取權限
- 逾時限制
- 重試上限
- 驗收測試
- 輸出格式
每次執行都應記錄模型專用的推理控制設定。
步驟 4:衡量工作流程結果
記錄:
- 通過或失敗
- 輸入 token 數
- 輸出 token 數
- 推理 token 數
- 工具呼叫次數
- 無效的工具呼叫
- 重試次數
- 總延遲
- 人工修正時間
- 最終成本
如此才能知道哪款模型真正完成工作,而非哪款模型寫出最令人信服的回答。
每個通過驗收任務的成本
token 價格只是成本的一部分。
使用以下公式:
每個通過驗收任務的成本 = 模型用量 + 工具呼叫 + 重試 + 備援呼叫 + 人工審查
假設有兩款模型:
|
指標 |
模型 A |
模型 B |
|
每次嘗試成本 |
$0.08 |
$0.22 |
|
驗收通過率 |
40% |
85% |
|
平均重試次數 |
1.8 |
0.3 |
|
人工審查 |
12 分鐘 |
3 分鐘 |
以單次請求評估時,模型 A 看似較便宜;若以每個通過驗收的任務評估,模型 B 可能便宜許多。
當 V4 Pro 較高的成功率足以減少重試、工程時間或營運風險,抵銷額外推論成本時,它在經濟上便具有合理性。
將推理強度作為路由變數
DeepSeek V4 Pro 支援 Non-think、Think High 及 Think Max 模式。
這些模式可視為不同的正式環境層級。
Non-think
適用於:
- 一般轉換
- 簡短說明
- 基礎程式設計問題
- 低風險決策
Think High
適用於:
- 除錯
- 多步驟規劃
- 技術分析
- 儲存庫問題
- 工具選擇
Think Max
適用於:
- 極為困難的任務
- 評估套件
- 複雜數學
- 高風險工程
- 較低推理強度下失敗的任務
每項請求都使用 Think Max,可能增加延遲與 token 用量,卻無法改善簡單工作的結果。
更完善的路由架構
穩健的部署可將請求處理分為四個階段。
階段 1:分類任務
判斷:
- 任務類別
- 預估複雜度
- 風險層級
- 所需模態
- 上下文大小
- 工具需求
由於 V4 Pro 僅支援文字,依賴圖片的請求應分流至多模態模型或視覺前處理步驟。
階段 2:選擇初始模型
將一般文字任務分流至較輕量的模型。
V4 Flash 可能適合的工作負載包括:
- 擷取
- 分類
- 摘要
- 直接的程式設計
- 初步儲存庫檢查
階段 3:驗證結果
驗證可包括:
- JSON Schema 檢查
- 單元測試
- 靜態分析
- 引用驗證
- 信賴度規則
- 商業限制條件
階段 4:必要時升級處理
在下列情況下呼叫 V4 Pro:
- 測試失敗。
- 驗證器拒絕輸出。
- 任務超過複雜度門檻。
- 必須同時分析多個元件。
- 請求具有較高風險。
- 較輕量模型回報證據不足。
如此可避免為較輕量模型已能處理的任務支付 V4 Pro 的成本。
DeepSeek V4 Pro vs V4 Flash:營運角色
|
正式環境角色 |
V4 Flash |
V4 Pro |
|
預設流量 |
非常適合 |
通常不必要 |
|
大量自動化 |
優先選擇 |
選擇性使用 |
|
複雜除錯 |
初次嘗試 |
升級處理層級 |
|
困難規劃 |
有限情況 |
優先選擇 |
|
整個儲存庫的變更 |
篩選或搜尋 |
最終推理 |
|
簡單擷取 |
優先選擇 |
容量過剩 |
|
高風險任務 |
前置工作 |
強力候選 |
|
100 萬 token 支援 |
是 |
是 |
|
啟用參數量 |
13B |
49B |
兩者的差異不是 V4 Flash「弱」而 V4 Pro「強」,而是它們最實用的正式環境角色不同。Flash 可以有效率地處理廣泛流量;Pro 則可專注於少部分需要更深入推理才能改變結果的請求。
僅支援文字就是僅支援文字
DeepSeek V4 Pro 無法透過標準模型介面原生檢查圖片。
若任務包含:
- 螢幕截圖
- 掃描文件
- 示意圖
- 圖表
- 影片影格
- 視覺版面
應用程式應選擇多模態模型,或建立如下管線:
- 多模態模型擷取視覺證據。
- 將證據轉換為結構化文字。
- V4 Pro 執行更深入的推理。
- 對照原始資料驗證結果。
使用獨立的視覺模型不會讓 V4 Pro 變成多模態模型,而是建立一套多模型工作流程。
透過 ApiSmart 存取 API
ApiSmart 目前列出的 DeepSeek-V4-Pro-0813 具備 1,024K 上下文視窗及 256K 最大輸出。
OpenAI 相容的基礎 URL 為:
https://gw.apismart.ai/v1
部署前,請確認目前的:
- 模型 ID
- 輸入與輸出價格
- 上下文限制
- 最大輸出
- 支援的參數
- 速率限制
- 可用性
Python 整合
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APISMART_API_KEY"],
    base_url="https://gw.apismart.ai/v1",
)

response = client.chat.completions.create(
    model="DeepSeek-V4-Pro-0813",
    messages=[
        {
            "role": "system",
            "content": (
                "You are reviewing a production software change. "
                "Identify the root cause, propose the smallest safe patch, "
                "and list the tests required to validate it."
            ),
        },
        {
            "role": "user",
            "content": (
                "A refresh token remains valid after the user changes "
                "their password. Analyze the likely control flow and "
                "propose a remediation plan."
            ),
        },
    ],
)

print(response.choices[0].message.content)
cURL 整合
curl "https://gw.apismart.ai/v1/chat/completions" \
  -H "Authorization: Bearer $APISMART_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "DeepSeek-V4-Pro-0813",
    "messages": [
      {
        "role": "system",
        "content": "Review production changes conservatively. Explain the root cause, propose a minimal patch, and define validation tests."
      },
      {
        "role": "user",
        "content": "A refresh token remains valid after the user changes their password. Analyze the likely control flow and propose a remediation plan."
      }
    ]
  }'
模型 ID 應從目前的 ApiSmart 目錄複製。請勿假設供應商別名與 ApiSmart 路由 ID 一定相同。
輸出限制與上下文預算
請勿為每項請求設定可用的最大輸出。
應同時為輸入及輸出保留上下文:
總上下文預算
= 系統指令
+ 對話
+ 檢索到的證據
+ 工具結果
+ 預期輸出
若 ApiSmart 路由支援 1,024K 上下文視窗及最高 256K 輸出,使用完整輸入容量將無法為最大長度回應保留足夠空間。
請依任務設定輸出限制:
|
任務 |
一般輸出需求 |
|
分類 |
數十個 token |
|
擷取 |
數百個 token |
|
程式碼審查 |
數百至數千個 token |
|
修補程式生成 |
取決於變更的檔案 |
|
研究報告 |
數千個 token |
|
儲存庫計畫 |
數千個 token |
較長的輸出限制會提高不必要生成及成本難以預測的風險。
可觀測性需求
V4 Pro 部署不應只追蹤請求數量。
請監控:
- 模型 ID 及版本
- 路由原因
- 推理模式
- 輸入 token 數
- 輸出 token 數
- 快取使用量
- 首個 token 延遲
- 總延遲
- 工具呼叫
- 重試次數
- 驗證器結果
- 備援使用情形
- 每個通過驗收任務的成本
這些欄位有助於判斷 V4 Pro 是否真正改善系統。例如,若 V4 Pro 接收 30% 的流量,卻只讓其中 2% 的請求提高驗收通過率,路由門檻可能設定得太低。
何時自行託管才有意義
DeepSeek V4 Pro 的權重以 MIT 授權發布。
在下列情況下,值得研究自行託管:
- 流量大且可預測。
- 資料所在地要求禁止使用託管推論。
- 組織已營運分散式 GPU 基礎設施。
- 需要自訂推論行為。
- 計畫包含模型修改或量化。
在下列情況下,API 存取通常更為實際:
- 流量大幅變動。
- 產品仍在驗證階段。
- 團隊缺乏推論專家。
- 快速部署相當重要。
- 重視營運簡便性。
1.6T 模型檢查點使自行託管成為重大的基礎設施工程。開放權重提供自由,但不代表營運免費。
為何 ApiSmart 適合路由策略
當每款模型都需要各自的下列項目時,路由系統會更難維護:
- 憑證
- SDK
- 計費帳戶
- 錯誤格式
- 用量後台
- 重試行為
- 供應商專用程式碼
ApiSmart 讓支援的模型使用同一套 OpenAI 相容 API 結構,因此團隊不必為每家供應商重建整合,即可切換模型。
ApiSmart 也公布:
- 可存取 200+ 款模型
- 全球邊緣加速
- 毫秒級容錯移轉
- 不保留請求內容
- 集中式用量紀錄
- 99.99% 可用性 SLA
如此便能只在 V4 Pro 確實能增加價值時使用它,而非將每項請求都傳送給它。
正式環境檢查清單
啟用 DeepSeek V4 Pro 前,請確認:
- 任務具有可衡量的驗收條件。
- 已確認目前的 ApiSmart 模型 ID。
- API 憑證儲存在伺服器端。
- 已定義輸入及輸出預算。
- 大型上下文已經過刻意篩選或檢索。
- 推理強度符合任務難度。
- 工具呼叫已通過綱要驗證。
- 重試設有嚴格上限。
- 已測試備援路由。
- 已了解僅支援文字的限制。
- 已監控用量、延遲及成本。
- 高風險輸出接受獨立驗證。
最終建議
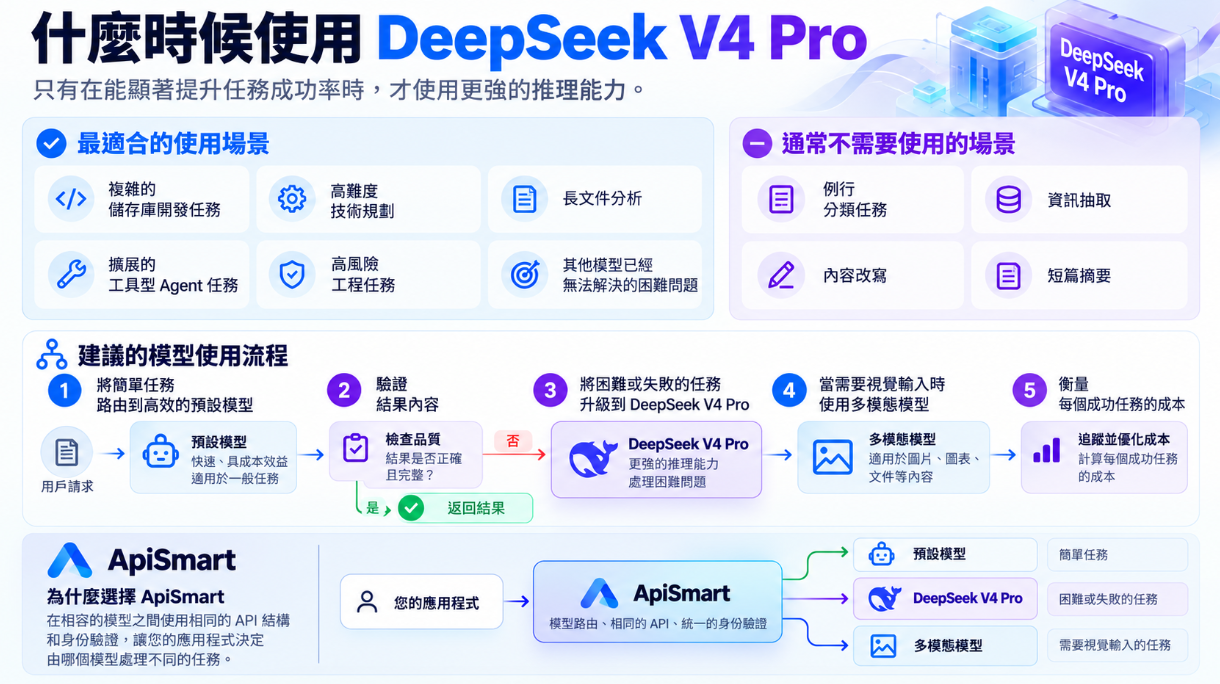
當額外推理容量能實質提高正確完成任務的機率時,使用 DeepSeek V4 Pro。這些情況包括複雜儲存庫作業、困難的技術規劃、長篇文件分析、長時間工具型代理、高風險工程任務,以及較輕量模型已無法解決的問題。一般分類、擷取、改寫及短篇摘要通常不需要它。
實務上,簡單的模型階層通常效果更好:
- 將簡單流量分流至高效率的預設模型。
- 驗證結果。
- 將困難或失敗的工作升級至 DeepSeek V4 Pro。
- 需要視覺輸入時使用多模態模型。
- 衡量每個通過驗收任務的成本。
ApiSmart 讓相容模型使用相同的 API 結構及驗證方式,由應用程式決定每項任務要交給哪款模型,因此能支援這種架構。
常見問題
DeepSeek V4 Pro 應該作為預設模型嗎?
通常不應該。它更適合複雜或高風險請求吗,一般任務通常可由 V4 Flash 或其他較輕量模型以更高效率處理。
DeepSeek V4 Pro 最適合哪些用途?
儲存庫規模的程式設計、困難推理、長篇文件分析及長時間工具型代理,都是它最適合的用途。
100 萬 token 上下文可以取代 RAG 嗎?
不可以。檢索仍可降低成本、延遲及無關上下文,同時讓結果更容易重現。
應如何評估 V4 Pro?
使用具備客觀驗收測試的真實任務,衡量成功率、重試、延遲、工具可靠性、人工修正及總成本。
DeepSeek V4 Pro 是多模態模型嗎?
不是,請將它視為文字模型。圖片、圖表、螢幕截圖或影片應使用獨立的多模態模型。
搭配 ApiSmart 時應使用哪個模型 ID?
ApiSmart 目前列出的是 DeepSeek-V4-Pro-0813。部署前請在 ApiSmart 目錄確認最新識別碼。
ApiSmart 目前的輸出限制是多少?
目前 ApiSmart 清單顯示,DeepSeek-V4-Pro-0813 的最大輸出為 256K。正式使用前應再次確認限制。
DeepSeek V4 Pro 可以自行託管嗎?
其權重以 MIT 授權提供,但營運一款具有 1.6T 參數的 MoE 模型,需要大量基礎設施及工程專業能力。
如何控制成本?
一般請求使用較小的模型、只檢索相關上下文、設定適當輸出限制、驗證回應,並只在必要時升級至 V4 Pro。