
Kimi K3 自架部署 vs API:硬體、成本與部署指南
 2026-10-07
 1357 次閱讀
Kimi K3 自架部署 vs API:硬體、成本與部署指南
自行部署 Kimi K3 在技術上是可行的。但這並不代表它在營運上很簡單,也不代表在經濟上一定合理。
Kimi K3 是一款具有 2.8 兆參數(2.8T)的 Mixture-of-Experts 模型,原生支援多模態能力,Context Window 最高可達 100 萬 Tokens。Moonshot 公開的模型 Repository 大約為 1.56 TB,而官方 Serving 指南一開始就要求多 GPU 環境,而不是一般開發者工作站。這也改變了部署決策的核心問題。
對多數團隊而言,真正需要考慮的並不是:「我們能不能下載 Kimi K3?」,而是:「在什麼規模下,自架部署會比使用託管 API 更實際?」
本指南將從硬體、基礎架構、工程投入、使用率、成本、授權、擴充性與營運風險等面向,比較 Kimi K3 自架部署與 API 存取方式,並說明什麼情況適合使用託管 API、自架 Cluster 或混合部署。
自架 Kimi K3 實際上代表什麼?
自架部署代表你的團隊需要負責完整的推論環境。
包括:
- 下載並儲存模型權重
- 建置 GPU 基礎架構
- 設定推論 Runtime
- 管理多 GPU 或多 Node 通訊
- 監控 GPU Memory 與利用率
- 處理模型升級
- 管理失敗與重新啟動
- 因應流量高峰進行擴充
- 維持延遲目標
- 保護部署環境安全
- 建立 Logging 與 Observability
- 規劃容量
使用託管 API,則可以將大部分這些責任交由 API 供應商負責。
應用程式通常只需要管理:
API Key
+
Endpoint
+
Model ID
+
應用程式邏輯
當模型本身規模如此龐大時,這種差異會變得更加重要。
為什麼 Kimi K3 自架成本很高?
Kimi K3 並不是那種可以輕鬆放進一兩張高階 GPU 的傳統 Dense Model。
Moonshot 將它描述為一款 2.8T 參數的 MoE 模型,每個 Token 會啟用 896 個 Experts 中的 16 個。模型使用 Kimi Delta Attention 與 Attention Residuals,並原生支援文字、圖片與影片理解。
雖然每個 Token 只會啟用模型的一部分,但完整模型仍然必須被儲存,並能由 Serving System 使用。完整的 Expert 集合仍然必須被儲存並提供給推論系統。
因此會產生以下需求:
- GPU Memory
- 模型儲存空間
- 高速互連
- 分散式推論
- KV Cache 管理
- 長 Context Memory
- Load Balancing
- Expert Routing
對正式環境團隊而言,Kimi K3 更像是一個完整的基礎架構專案,而不是單純下載模型。
Kimi K3 模型大小
Kimi K3 官方 Hugging Face Repository 大約為:1.56 TB。在這種規模下,儲存與部署本身就成為需要解決的問題。
正式環境除了需要儲存模型本身,也要預留足夠空間給:
- 暫存檔
- Container Images
- Cache
- Logs
- 模型版本
- Checkpoints
- 監控資料
模型分發也可能成為營運問題。
如果 Cluster 包含許多 Node,反覆下載超過 1 TB 的模型資料,可能會大幅增加部署時間。
因此團隊可能需要:
集中式模型儲存
↓
高速網路
↓
GPU Nodes
↓
本機 Cache
這些都應納入基礎架構規劃。
Kimi K3 硬體需求
vLLM 團隊官方的 Kimi K3 部署指南指出,最簡單的 Serving 方式是使用:
- 8 張 NVIDIA B300 GPU
- 或 8 張 AMD MI355X GPU
這已經遠超過許多較小型開放模型所需要的硬體規模。
簡化後的部署架構可能如下:
應用程式
↓
Load Balancer
↓
Inference Server
↓
8+ 張高階 GPU
↓
Kimi K3
正式環境可能還需要更多硬體,具體取決於:
- 同時在線使用者數量
- Context Length
- Output Length
- 延遲目標
- 大量 Tool Calling 的 Agent 工作流程
- 多模態流量
- 所需的備援能力
因此應將這套配置視為起始參考,而不是正式環境的固定保證配置。
長 Context 會讓基礎架構更昂貴
Kimi K3 支援最高 100 萬 Token Context Window。
長 Context 對以下應用很有價值:
- 大型 Repository
- 長時間研究工作
- 文件集合
- Agent 歷史紀錄
- 多檔案除錯
- 長篇知識工作
但更大的 Context Window 同時也會增加記憶體壓力。
包含數十萬 Tokens 的請求,與短篇 Chat Completion 完全不是同一種工作負載。
基礎架構規劃需要考慮:
更長的 Context
↓
更大的 KV Cache
↓
更多 GPU Memory
↓
較低的有效併發量
因此,單純看「每分鐘請求數」並不足以進行容量規劃。
兩個每分鐘請求量完全相同的應用,如果其中一個長期使用更大的 Context,其所需基礎架構可能完全不同。
自架不只需要 GPU
GPU 費用只是整體成本的一部分。
一套比較完整的自架部署通常還需要:
- CPU Servers
- 高速 NVMe Storage
- 高速網路
- Load Balancers
- Monitoring
- Backup Infrastructure
- Container Orchestration
- 工程人員
- Security Controls
- Redundant Nodes
- 如果部署在地端,還需要電力與散熱
更合理的成本模型應包含:
自架總成本

=

GPU 成本

+ 儲存

+ 網路

+ CPU / RAM

+ 工程成本

+ 監控

+ 可靠性建設

+ 閒置容量
如果忽略這些項目,自架看起來可能會比實際成本便宜很多。
自架成本本質上是「利用率」問題
即使沒有人送出請求,GPU Cluster 仍然持續產生成本。
這是自架與 API 存取方式之間最大的差異之一。
假設有兩個應用程式。
應用程式 A
- 上班時間使用量很高
- 晚上幾乎沒有流量
- 週末流量很低
- 偶爾突然出現流量高峰
應用程式 B
- 24/7 流量穩定
- Request Size 穩定
- GPU 利用率高
- 需求容易預測
應用程式 B 更適合自架,應用程式 A 則可能要為大量閒置容量支付成本。
因此真正重要的指標並不是:GPU 價格 而是:GPU 利用率
範例:為什麼閒置容量很重要?
假設一個 Cluster 每小時成本為:
$X / 小時
如果持續運作:
每月基礎架構成本

≈

$X × 24 × 30
即使平均利用率只有 25%,企業仍然必須支付整套 Cluster 的完整成本。因此,每個真正有用 Request 的實際運算成本會變得更高。
使用託管 API,成本結構通常更接近:
實際使用量
↓
Tokens / Requests
↓
變動成本
當使用量還不高或很難預測時,這種方式通常更便宜。
託管 API 的成本結構
託管 API 通常會把基礎架構支出轉換成依照使用量計算的變動成本。
企業不需要購買或租用專屬 Cluster,而是依照 API 供應商的計價方式付費。
LLM API 常見的計費依據包括:
- Input Tokens
- Output Tokens
- Cached Input
- Requests
- Model-specific Usage
一般每月 API 成本可以估算為:
每月 API 成本

=

(Input Tokens × Input Price)

+

(Output Tokens × Output Price)
如果支援 Cache:
每月 API 成本

=

Cached Input Cost

+

Uncached Input Cost

+

Output Cost
這種方式可以更清楚看出基礎架構成本如何隨實際產品使用量變化。
自架 vs API:核心比較
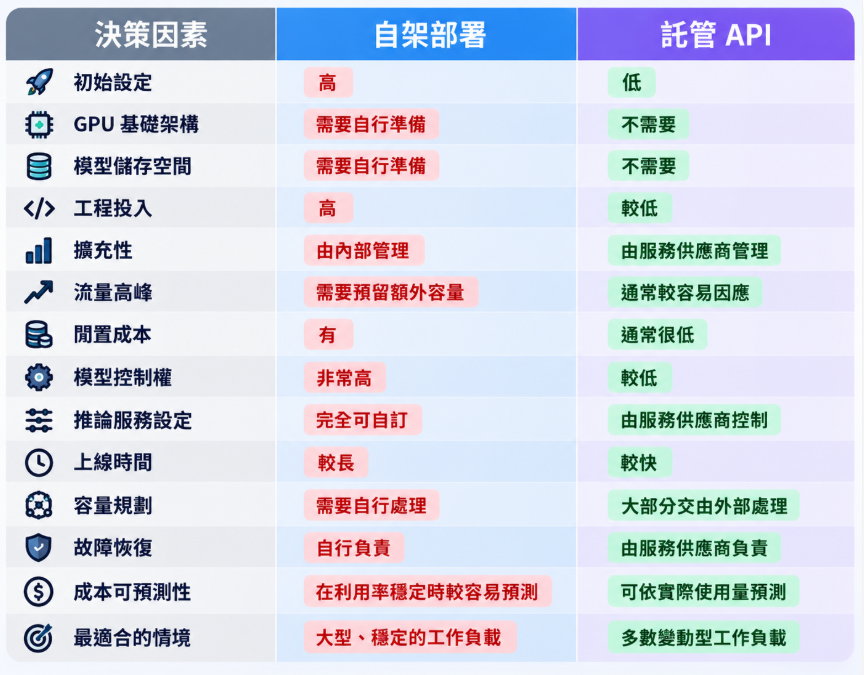
沒有任何一種方式永遠較好,正確選擇取決於工作負載本身的特性。
什麼情況下託管 API 更合理?
如果團隊還在驗證產品,託管 API 通常會是更實際的選擇。
1. 流量難以預測
如果需求波動很大,API 可以避免為大量閒置 GPU 容量支付費用。
常見情況包括:
- 新產品
- 內部原型
- 早期 SaaS
- 季節性應用
- 實驗型 Agent
2. 需要快速上線
自架需要先完成基礎架構準備。託管 API 因為推論平台已由供應商管理,所以團隊可以更快從 Prototype 進入 Production。
3. 沒有專門的推論基礎架構團隊
運行超大型 MoE 模型需要專業工程能力。
團隊可能需要熟悉:
- vLLM
- SGLang
- Tensor Parallelism
- Expert Parallelism
- Distributed Serving
- GPU Scheduling
- KV Cache Optimization
- Performance Tuning
如果內部原本沒有這些能力,人力成本可能會相當可觀。
4. 需要彈性擴充
API 流量可能突然大幅改變。
例如:
一般負載

████

產品發布

████████████████████

一般負載

████
自架環境需要預留足夠容量才能承受高峰,API 則可以將這部分容量問題交由供應商處理。
5. 想比較不同模型
團隊可能還不確定 Kimi K3 是否會成為最後選定的模型。透過託管 API,可以先使用相同正式工作負載測試不同模型,再決定是否投入大量基礎架構成本。
這對以下工作負載特別重要:
- Coding Agent
- Research Agent
- Long-context 應用
- 多模態系統
- 企業知識工具
什麼情況下自架更合理?
當多項條件都已具備時,自架部署就值得認真評估。
穩定且高利用率
如果 Cluster 一天大部分時間都接近滿載,經濟效益可能會變得更好。
穩定工作負載可以讓昂貴 GPU 持續產生價值,而不是大量時間處於閒置狀態。
已有 GPU 基礎架構
已經營運大型 GPU Cluster 的企業,與完全從零開始的團隊,其成本結構會非常不同。
這些企業可能已經擁有:
- GPU Servers
- Networking
- Storage
- Observability
- Platform Engineering
- Deployment Automation
對這些企業而言,新增 Kimi K3 的成本可能遠低於從零建立整套基礎架構。
需要更高控制權
自架可以提供更多控制:
- Serving Configuration
- Quantization
- Scheduling
- 模型修改
- Network Architecture
- Data Routing
- Logging
- Performance Optimization
對高度客製化環境而言,這些能力可能非常重要。
需要直接存取模型權重
Moonshot 已經透過 Kimi K3 License 公開 Kimi K3 權重。
因此,在符合授權條款的情況下,可以進行:
- 研究
- 部署
- 模型層級實驗
託管 API 通常不會提供同等程度的模型控制權。
什麼情況適合混合部署?
這個選擇不一定只能二選一。
部分團隊可能適合:
穩定基礎流量
↓
自架 Kimi K3
流量高峰
↓
託管 API
這種方式可以降低閒置基礎架構成本,同時仍保留自有基礎 Serving 環境。
混合架構還可以支援:
- 災難恢復
- 容量 Overflow
- API 供應商故障
- 區域 Failover
- 測試新模型版本
例如:
應用程式
↓
Router
┌────────┴────────┐
↓ ↓
自架 Kimi K3 託管 API
基礎負載 Overflow
應用程式可以依照容量與政策,決定每個 Request 應送到哪裡。
計算真正的損益平衡點
是否自架,應根據總成本判斷,而不是只比較 GPU 價格與 API Token 價格。
API 成本
估算:
API Cost

=

Monthly Input Tokens

× Input Price

+

Monthly Output Tokens

× Output Price
接著還要納入:
- Cache Pricing
- Retries
- Failed Tasks
- Tool Loops
- Large-context Requests
自架成本
估算:
Self-Hosting Cost

=

GPU Infrastructure

+

Storage

+

Networking

+

Engineering

+

Operations

+

Redundancy

+

Idle Capacity
接著計算:
每個成功任務的實際成本

=

每月總成本

÷

成功正式環境任務數
這通常比「每 Token 成本」更有意義。
為什麼每個成功任務的成本更重要?
假設 Model A 每 Token 比較便宜,但需要大量重試。Model B 每 Token 比較貴,但成功率較高。
企業真正關心的是:每個被接受結果的成本 ,而不是:每 Token 成本
例如:
Model A

每次嘗試 $0.50

50% 被接受

≈ 每個可接受結果 $1.00
Model B

每次嘗試 $0.70

90% 被接受

≈ 每個可接受結果 $0.78
這個原則對 Agent 任務尤其重要。
Coding Agent 可能會將 Token 花在:
- Repository 探索
- 規劃
- Tool Calls
- Debugging
- Test Execution
- Revisions
最便宜的 Token 價格,不一定能帶來最便宜的最終任務。
購買 GPU 前先測量真實工作負載
在投入自架之前,團隊應該先從真實應用流量蒐集使用資料。
建議指標包括:
- 平均 Input Tokens
- 平均 Output Tokens
- P95 Context Size
- Requests Per Minute
- Peak Concurrency
- 每個任務的 Tool Calls
- Retry Rate
- Successful-task Rate
- Average Latency
- P95 Latency
- Cache Hit Rate
- 每日流量分布
- 每個成功任務的成本
蒐集數週後,這些資料就可以用來估算自架所需的基礎架構。如果沒有這些資料,容量規劃基本上只是猜測。
使用自己的工作負載 Benchmark,而不是只看通用分數
Kimi K3 專為以下工作負載而設計:
- Long-horizon Coding
- Knowledge Work
- Multimodal Reasoning
- Agentic Workloads
Moonshot 將其描述為能夠處理長時間工程任務、大型 Repository 瀏覽、Terminal Orchestration 以及端到端知識工作。但公開 Benchmark 無法告訴你正式環境的實際經濟效益。
更好的評估方式可能是:
100 個真實 Coding Tasks
+
100 個 Research Tasks
+
50 個 Multimodal Tasks
+
50 個 Long-context Tasks
每個任務都測量:
- Accuracy
- Completion Rate
- Latency
- Token Usage
- Retry Count
- Human Acceptance
- Cost
這些結果通常比公開 Benchmark 分數更有參考價值。
自架會帶來更多營運風險
自架同時代表故障恢復需要由自己的團隊負責。
常見基礎架構問題包括:
- GPU Failure
- Node Failure
- Network Degradation
- Out-of-memory Errors
- Model Server Crashes
- Cache Corruption
- Deployment Failures
- Capacity Shortages
正式環境需要足夠的備援能力來承受這些故障。
例如:
Request
↓
Load Balancer
↓
Healthy Inference Pool
↓
Kimi K3 Cluster
如果其中一個 Node 故障,系統仍必須繼續提供服務。備援可以提高可靠性,但同時也會增加成本。
模型更新也是成本
模型部署不是一次性專案。
新的模型版本可能需要:
- 下載新權重
- 更新 Serving Software
- Compatibility Testing
- Benchmarking
- Canary Deployments
- Rollbacks
使用託管 API 時,大部分基礎架構工作由供應商處理。自架則代表整個模型生命週期都由自己的團隊負責。
API 可以作為驗證階段
對許多團隊而言,最實際的策略是:
階段 1
透過 API 建立 Prototype
↓
階段 2
測量真實使用量
↓
階段 3
計算基礎架構成本
↓
階段 4
決定是否自架
這能讓自架決策建立在實際資料上。與其預測工作負載行為,不如直接測量。
ApiSmart 如何融入託管 API 策略
ApiSmart 讓開發者可以透過單一 API Layer 存取支援的模型。
團隊可以先透過 ApiSmart 測試 Kimi K3,而不需要一開始就為特定供應商建立獨立整合。
簡化架構如下:
你的應用程式
↓
ApiSmart
↓
Kimi K3
目前 ApiSmart Base URL 為:
https://gw.apismart.ai/v1
實作 Kimi K3 時,請使用目前 ApiSmart Dashboard 或文件中顯示的正確 Model ID。
如果範例中的 Model ID 尚未獨立確認,應使用:
YOUR_KIMI_K3_MODEL_ID
實用決策框架
可以使用簡單的決策流程:
你是否已經擁有大型 GPU 基礎架構?
│
┌─────┴─────┐
│ │
否 是
│ │
託管 API 流量是否穩定?
│
┌─────┴─────┐
│ │
否 是
│ │
託管 API 利用率是否高?
│
┌─────┴─────┐
│ │
否 是
│ │
託管/混合 評估
自架部署
模型權重開放,本身並不是自架的充分理由。
API 存取可能是更好的選擇,如果:
- 你仍在驗證 Kimi K3
- 流量難以預測
- 使用量低或中等
- 需要快速部署
- 沒有 GPU 基礎架構
- 沒有推論工程團隊
- 想存取多個模型
- 流量高峰明顯
- 想避免 GPU 閒置成本
值得認真評估自架,如果:
- 已經營運高階 GPU 基礎架構
- 工作負載可預測
- GPU 利用率可以長期維持高水準
- Kimi K3 是長期核心依賴
- 需要低層級 Serving 控制
- 需要直接存取模型權重
- 團隊具備 Distributed Inference 專業能力
- 總成本模型顯示自架具有明顯優勢
混合部署適合以下情況:
- 基礎流量可預測
- 尖峰流量難以預測
- 想保留自架控制權,但需要 Overflow Capacity
- 需要外部 Fallback
- 希望從 API 逐步遷移至自架
混合架構可以避免團隊被單一部署模式綁死。
常見問題
Kimi K3 可以自架嗎?
可以。Kimi K3 提供 Open Weights,因此技術上可以自架。不過,它需要多 GPU Datacenter Cluster 以及專門的 Machine Learning Engineering 資源。它並不適合在單一工作站或一般消費級 GPU 上執行。另一個選擇是透過 ApiSmart 的託管 API 存取 Kimi K3。
Kimi K3 有多大?
Kimi K3 是一款 Mixture-of-Experts(MoE)模型,擁有 2.8 兆總參數。在推論過程中,每個 Token 大約會啟用 1030 億參數。
Kimi K3 需要哪些 GPU?
vLLM 的 Kimi K3 部署指南指出,最容易使用的 Serving 配置是:
- 8 張 NVIDIA B300 GPU
- 或 8 張 AMD MI355X GPU
正式環境需求可能更高,取決於流量與 Context Length。
Kimi K3 支援長 Context 嗎?
支援。Kimi K3 原生提供 100 萬 Token Context Window。
Kimi K3 是開源模型嗎?
Kimi K3 更準確的說法是 Open-weight,而不是採用 MIT 或 Apache 等授權的完全 Open-source 模型。它使用自訂的 Kimi K3 License。多數商業用途可使用,但高營收或高 MAU 的大型 SaaS 服務,需要另外與 Moonshot AI 簽訂協議。
自架一定比使用 API 便宜嗎?
不一定。當 GPU 利用率長期保持高水準,而且企業原本就具備所需基礎架構與工程能力時,自架才可能更具有成本優勢。對流量波動大或仍處於早期階段的工作負載而言,API 往往更經濟。
新創公司應該自架 Kimi K3 嗎?
對大多數沒有現成大型 GPU 基礎架構的新創團隊而言,使用託管 API 通常是風險較低的起點。之後可以根據真實使用資料,再評估自架是否具有經濟效益。
自架前應該測量哪些數據?
在決定自架之前,應測量:
- 平均流量
- 尖峰流量
- Context Length
- Concurrency
- Latency
- Retry Rate
- Cache Usage
- Successful-task Rate
- 每個成功任務的成本
這些數據都是估算 GPU 容量與總基礎架構成本的重要依據。
可以透過 ApiSmart 使用 Kimi K3 嗎?
可以。你可以透過 ApiSmart 統一、OpenAI 相容的 API 存取 Kimi K3。
結論
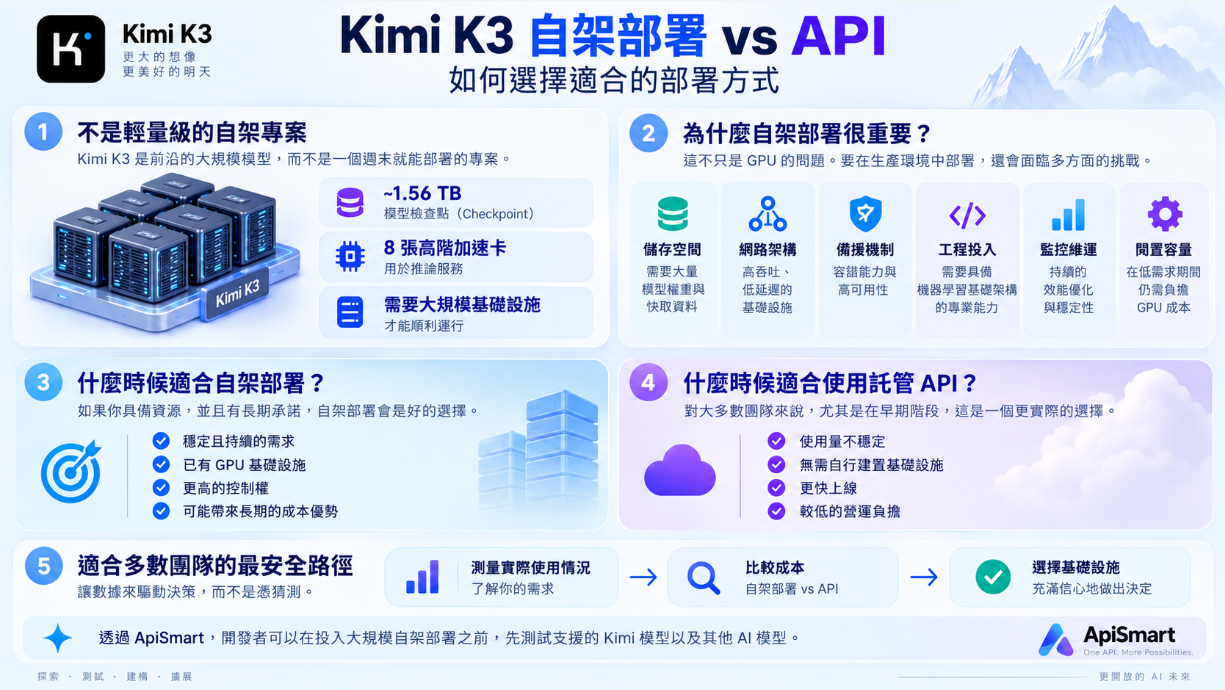
Kimi K3 的模型權重可以公開取得,並不代表它是一個輕量級的自架專案。
模型本身規模非常龐大,官方 Checkpoint 約為 1.56 TB,而 Serving 建議配置一開始就需要 8 張高階加速卡。如果再把儲存、網路、備援、工程人力、監控以及閒置容量計算進去,自架就會成為一項非常重大的基礎架構投資。
對於已經擁有 GPU 基礎架構,而且需求穩定、持續且規模較大的團隊,自架可能提供更高的控制權,並在長期帶來更好的成本效益。但對流量不穩定、基礎架構有限,或希望快速上線的團隊而言,使用託管 API 通常是更實際的起點。
對許多團隊來說,最穩健的方式是:先透過 API 測量真實使用量,再決定是否投入大型自架基礎架構。
透過 ApiSmart,開發者可以先測試支援的 Kimi 模型以及其他 AI 模型,再決定是否投入大型自架部署。