
DeepSeek V4.1 Flash vs V4 Pro:哪一款模型適合正式環境工作負載?
 2026-10-24
 1405 次閱讀
DeepSeek V4.1 Flash 改變了「Flash」模型與「Pro」模型之間常見的關係。
一般而言,Flash 模型會以較低的延遲及成本,換取部分智慧能力,但 V4.1 Flash 並不符合這種簡單模式。DeepSeek 表示,新模型採用更有效率的架構,同時在多項程式設計、終端機、自動化及代理評估中超越 V4 Pro。
這並不表示 V4 Pro 對所有工作負載都已失去價值。它仍在部分純推理任務中具備優勢,而且既有應用程式可能依賴其已建立的行為模式。
因此,真正的問題不是哪款模型聽起來更強大,而是工作負載更能受益於代理執行、原生視覺及吞吐量,還是需要保留 V4 Pro 在特定推理任務中的行為及效能。
簡短結論
需要下列功能時,選擇 DeepSeek V4.1 Flash:
- 程式設計及儲存庫層級自動化
- 終端機型代理
- 工具呼叫及工作流程執行
- 原生圖片理解
- 高請求吞吐量
- 高效率長上下文處理
- 較低的推論成本
- 作為一般正式環境工作負載的新預設模型
需要下列功能時,繼續評估 DeepSeek V4 Pro:
- 與現有 V4 Pro 工作流程相容
- 重現先前的 V4 Pro 結果
- 在特定閉卷推理任務上取得優異表現
- 採取受控遷移,而非立即替換模型
- 為已針對 V4 Pro 最佳化的提示詞保留穩定行為
對多數新應用程式而言,V4.1 Flash 是更好的起點。已建立 V4 Pro 提示詞的正式環境系統,應在變更模型設定前執行結構化遷移測試。
DeepSeek V4.1 Flash vs V4 Pro 快速比較
|
類別 |
DeepSeek V4.1 Flash |
DeepSeek V4 Pro |
|
主要優先目標 |
以更高效率提供強大能力 |
旗艦級推理及已建立的行為模式 |
|
架構 |
因果編碼器-解碼器 MoE |
大型稀疏 MoE |
|
骨幹參數量 |
552B |
1.6T |
|
啟用參數量 |
輸入時 8B,輸出時 16B |
每個 token 約 49B |
|
上下文視窗 |
最高 100 萬 token |
最高 100 萬 token |
|
思考模式 |
支援 |
支援 |
|
非思考模式 |
支援 |
支援 |
|
原生圖片理解 |
是 |
否 |
|
程式設計與代理工作負載 |
公布的評估通常較強 |
表現強勁,但在許多執行型任務上落後於 V4.1 Flash |
|
特定純推理測試 |
強 |
在部分測試中仍有優勢 |
|
服務效率 |
較高 |
較低 |
|
最適合 |
新型、大量及多模態應用 |
舊有相容性及特定推理工作負載 |
模型規格及 API 限制可能因平台或路由而異。部署前,請在 ApiSmart 後台確認目前的模型 ID、上下文限制及支援參數。
為什麼 V4.1 Flash 不只是較小的 V4 Pro
架構差異相當重要,因為輸入處理與輸出生成並不一定需要相同的運算量。
長上下文代理可能先處理大量輸入,再生成相對簡短的回答。傳統架構可能在兩個階段都採用相近的啟用參數預算,進而提高處理提示詞的成本。
DeepSeek V4.1 Flash 採用具有非對稱運算模式的因果編碼器-解碼器架構:
- 輸入處理期間約啟用 80 億個參數。
- 輸出生成期間約啟用 160 億個參數。
模型共有 5,520 億個骨幹參數,因此讀取提示詞時能使用較少運算量,生成回答時則投入更多運算量。
V4 Pro 使用規模大得多的稀疏混合專家設計,約有 1.6 兆個骨幹參數,每個 token 的啟用參數量也更高。
總參數量較大,不代表每項任務都必然產生更好的結果。架構、訓練、後訓練、工具設定及啟用運算量都會影響實際效能。
長上下文效率與 KV Cache
長上下文應用程式的限制不只來自模型智慧。
當代理反覆處理不斷增加的對話、儲存庫或工具歷程時,其鍵值快取會占用加速器記憶體、儲存空間及資料傳輸頻寬。這些基礎設施需求可能成為服務成本的重要部分。
DeepSeek 表示,V4.1 Flash 將整體 KV Cache 占用量降低至每個 token 約 890 位元組。其技術論文指出,這約為上一代 V4 Flash 相應占用量的四分之一,而持久性快取需求可降至先前水準的約八分之一。
實際上,這可能代表:
- 更低的長上下文服務成本
- 大量工作負載下更高的吞吐量
- 更有效率地處理重複提示詞
- 提升長時間執行代理的擴充能力
- 大型上下文處理對基礎設施造成較少壓力
不過,不應因為支援 100 萬 token 上下文視窗,就在每項請求中傳送所有可用檔案。檢索及上下文選擇仍然不可或缺。
程式設計與儲存庫作業
V4.1 Flash 最大的優勢,出現在模型必須真正完成工作,而不只是回答推理問題的軟體任務。
這些工作負載包括:
- 儲存庫調查
- 跨檔案程式碼變更
- 終端機操作
- 程式合成
- 自動化除錯
- 測試生成與執行
- 安全分析
- 工具輔助軟體工程
正式環境程式設計模型的評估標準,應是它能否完成任務,而不只是能否產生看似合理的程式碼。
實用的評估工作流程如下:
- 向兩款模型提供相同的儲存庫快照。
- 使用相同的系統提示詞及可用工具。
- 指派相同的問題或失敗測試。
- 提供相同的時間及 token 預算。
- 使用測試套件驗證生成的修補程式。
- 記錄工具呼叫、重試及人工修正。
- 比較成功完成任務的成本。
與比較單獨程式設計提示詞的回答相比,這能提供更有價值的資訊。
DeepSeek 公布的評估顯示,V4.1 Flash 在多項終端機、儲存庫、自動化及代理基準測試中優於 V4 Pro。這些改進無法證明它在每個私人程式碼庫上都會勝出,因此團隊仍應測試具代表性的內部任務。
純推理:V4 Pro 可能仍具價值的領域
V4.1 Flash 並未在所有公布的比較中勝出。
在參考基準測試集的部分閉卷評估中,包括 GPQA Diamond 及相近的純文字 HLE 結果,V4 Pro 仍具優勢。
這對下列工作負載相當重要:
- 沒有外部工具協助的困難科學問題
- 抽象推理問題
- 專家層級知識評估
- 模型必須完全依據所提供知識進行推理的任務
- 依 V4 Pro 行為校準的既有工作流程
這不代表 V4 Pro 在所有推理任務上都更好。其優勢較為集中:部分不使用工具或視覺輸入的任務可能仍更適合它。
若正式環境應用程式需要處理技術或科學決策,請建立特定領域的推理資料集,並以盲測方式評估兩款模型。
原生視覺能力改變了選擇方式
DeepSeek V4.1 Flash 支援原生圖片理解,而目前的 V4 Pro API 路由未列出視覺支援。
這讓 V4.1 Flash 在下列用途具有明顯優勢:
- 以螢幕截圖進行除錯
- 使用者介面檢查
- 文件圖片擷取
- 圖表解讀
- 視覺問答
- 瀏覽器代理
- 電腦操作工作流程
- 產品及設備圖片分析
例如,前端代理可以接收算繪後的螢幕截圖、找出可見的版面問題、修改程式碼,再檢查更新後的頁面。
若使用 V4 Pro,相同工作流程將需要獨立的視覺模型或額外圖片處理階段。這會增加另一款模型、更多路由,以及更多可能導致工作流程失敗的環節。
吞吐量與並行量
目前的 DeepSeek API 文件列出 V4.1 Flash 的並行上限為 2,500,V4 Pro 則為 500。
較高的並行量對下列用途尤其重要:
- AI 程式設計平台
- 批次文件處理
- 企業助理
- 客戶服務系統
- 自動化評估管線
- 多租戶代理產品
- 流量尖峰難以預測的應用程式
文件記載的上限較高,不保證每項請求都有較低延遲。提示詞大小、輸出長度、推理模式、供應商負載及路由狀況仍會影響回應時間。
團隊應測量:
- 首個 token 回應時間
- 總回應時間
- 每秒生成 token 數
- 佇列等待時間
- 錯誤率及重試率
- 並行負載下的效能
- 每個成功請求的成本
應以每個已完成任務衡量成本
V4.1 Flash 的官方 token 費率,包括快取輸入、非快取輸入及輸出,都明顯低於 V4 Pro。官方價格可能變更,ApiSmart 價格也可能與 DeepSeek 第一方費率不同。編列預算前,請查看即時 ApiSmart 模型清單。
單靠 token 價格不足以估算正式環境成本。
更好的公式是:
每個已完成任務的成本 = 模型及工具總成本 ÷ 成功完成的任務數量
計算時應包括:
- 輸入及輸出 token
- 提示詞快取效能
- 模型重試
- 工具呼叫
- 失敗操作
- 驗證請求
- 人工審查
- 升級至其他模型
如果價格較高的模型能一次完成任務,它仍可能更經濟。若價格較低的模型反覆呼叫錯誤工具或生成無法使用的輸出,成本反而可能提高。
V4.1 Flash 因較低費率及優異執行結果,對大量代理工作相當有吸引力,但最終決策仍應以端對端測試為依據。
思考與非思考模式
兩款模型都支援思考及非思考運作模式。
非思考模式適合:
- 分類
- 資料擷取
- 簡單改寫
- 短篇摘要
- 一般格式整理
- 低延遲對話回應
思考模式適合:
- 複雜除錯
- 架構分析
- 儲存庫層級變更
- 多步驟規劃
- 安全調查
- 困難推理
- 工具驅動代理
請勿預設每項請求都使用最高推理強度。應依任務難度選擇模式,只有在任務真正需要時才增加推理。
一種可能的政策如下:
|
任務類別 |
初始模式 |
升級條件 |
|
分類及擷取 |
非思考 |
結構無效或信賴度低 |
|
一般程式設計 |
思考 |
第一個修補程式未通過測試 |
|
儲存庫修復 |
思考 |
缺少證據或測試涵蓋不完整 |
|
視覺檢查 |
非思考或思考 |
多個相互影響的缺陷 |
|
研究 |
思考 |
來源衝突或結論不確定 |
|
工具代理 |
思考 |
工具反覆失敗或偏離計畫 |
正式環境使用前,請確認目前 ApiSmart 路由支援的確切思考模式參數格式。
現有 V4 Pro 應用程式應該遷移嗎?
多數團隊都應測試 V4.1 Flash,但 API 相容並不表示模型的行為會與 V4 Pro 完全相同。
變更模型可能影響:
- 工具選擇
- JSON 格式
- 推理長度
- token 用量
- 提示詞敏感度
- 程式碼風格
- 拒絕行為
- 圖片處理
- 延遲
- 快取效能
安全的遷移流程包括下列階段。
1. 建立具代表性的評估資料集
從正式環境收集真實提示詞,而非只建立人工範例。
包括:
- 常見請求
- 困難請求
- 先前失敗的案例
- 長上下文任務
- 工具呼叫
- 結構化輸出請求
- 高影響力邊界案例
2. 在相同條件下執行兩款模型
下列變數應保持一致:
- 系統提示詞
- 工具定義
- 上下文
- 取樣設定
- 重試政策
- 時間限制
- 最大輸出
- 評估標準
3. 評估端對端結果
衡量最終任務是否成功。請勿只評估文字風格或主觀回應品質。
4. 使用影子流量
將一部分正式環境請求傳送給 V4.1 Flash,但不向使用者顯示其回應。再將結果與目前使用的 V4 Pro 路由比較。
5. 逐步提高流量
先從低風險工作負載開始,只有在錯誤率、延遲及任務品質維持於可接受範圍後,才逐步擴大。
6. 保留回復選項
將模型名稱儲存在組態中,不要分散硬編碼在整個應用程式內。
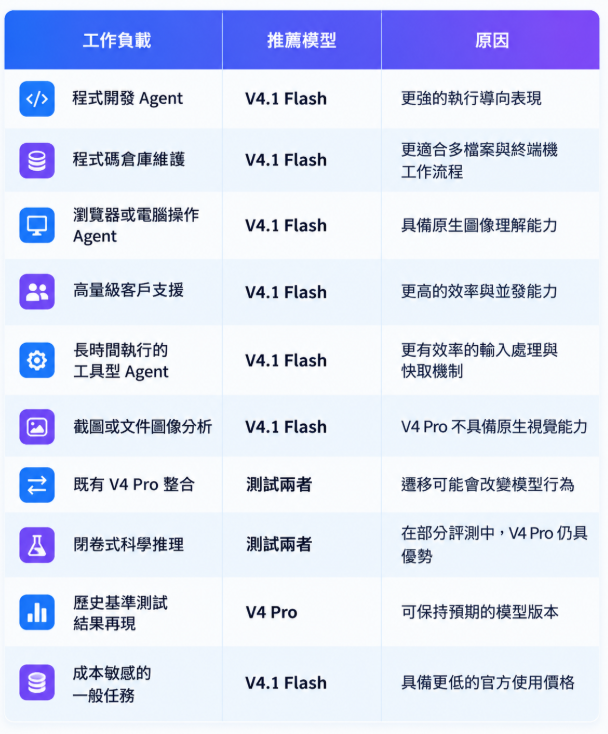
依工作負載選擇適合的模型
透過 ApiSmart 存取 DeepSeek 模型
ApiSmart 讓開發者透過同一套 OpenAI 相容 API 存取支援的 AI 模型。在許多情況下,應用程式可以保留相同的請求結構,只變更模型 ID。
ApiSmart 的標準端點為:
https://gw.apismart.ai/v1
使用任一 DeepSeek 模型前:
- 建立 ApiSmart 帳號。
- 產生 API 金鑰。
- 開啟目前的模型清單。
- 找到所需的 DeepSeek 路由。
- 複製後台顯示的確切模型 ID。
- 查看目前的價格、上下文及輸出限制。
ApiSmart 的公開模型頁面目前列出 DeepSeek V4 Flash 及 DeepSeek V4 Pro 路由。由於別名及後端版本可能變更,進行比較前請確認每個路由實際解析至哪個後端版本。
Python 請求範例
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APISMART_API_KEY"],
    base_url="https://gw.apismart.ai/v1",
)

response = client.chat.completions.create(
    model="YOUR_DEEPSEEK_MODEL_ID",
    messages=[
        {
            "role": "system",
            "content": (
                "You are a senior software engineer. "
                "Identify the root cause before proposing the smallest safe fix."
            ),
        },
        {
            "role": "user",
            "content": (
                "Review this service migration plan and identify "
                "the three highest-risk assumptions."
            ),
        },
    ],
)

print(response.choices[0].message.content)
請將 YOUR_DEEPSEEK_MODEL_ID 替換成 ApiSmart 後台顯示的確切識別碼。
cURL 請求範例
curl "https://gw.apismart.ai/v1/chat/completions" \
  -H "Authorization: Bearer $APISMART_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "YOUR_DEEPSEEK_MODEL_ID",
    "messages": [
      {
        "role": "user",
        "content": "Analyze this deployment plan and return the risks as structured JSON."
      }
    ]
將模型 ID 儲存在環境變數或組態服務中,可更方便地比較路由,或在遷移後回復至先前模型。
為什麼使用 ApiSmart 評估模型?
傳送一項請求很簡單,真正困難的是為每家供應商分別維護帳號、驗證、計費及整合程式碼。
ApiSmart 將模型存取、驗證、用量追蹤、路由及容錯移轉整合至同一平台。
當 V4.1 Flash 與 V4 Pro 只是大型路由策略中的兩個候選模型時,這項能力尤其實用。
團隊可以將程式設計、視覺及大量代理工作交給 V4.1 Flash,同時將特定推理任務分流至 V4 Pro 或其他模型。如此應用程式便能切換模型,不必將每項功能綁定至不同的供應商整合。
最終結論
DeepSeek V4.1 Flash 已不再只是 V4 Pro 的低價備用選項。其更有效率的架構、較小的 KV Cache、原生視覺能力及優異的執行結果,使它成為許多新應用程式合理的預設模型。
當您需要 V4 Pro 已建立的行為、歷史結果重現能力,或特定閉卷推理任務上的較佳結果時,V4 Pro 仍然合理,它的角色更為集中,但不應只因較新模型在更多公開基準測試中領先,就將它從正式環境系統中移除。
對新的部署而言,請先從 V4.1 Flash 開始,只在推理優勢可能值得額外成本的任務上測試 V4 Pro。如果已在使用 V4 Pro,請以真實正式環境任務執行兩款模型、比較每個已完成任務的成本,再逐步遷移。
透過 ApiSmart,團隊可以使用相同的 API 結構測試兩款模型,並依真實工作負載效能進行選擇,而非只根據 Flash 或 Pro 標籤。
常見問題
DeepSeek V4.1 Flash 比 V4 Pro 更好嗎?
V4.1 Flash 在許多公布的程式設計、終端機、自動化、代理及工具使用評估中表現較佳。V4 Pro 在特定純推理測試中仍然更強,因此正確選擇取決於工作負載。
DeepSeek V4.1 Flash 支援圖片嗎?
支援。V4.1 Flash 包含原生視覺理解能力,目前的 V4 Pro API 文件未列出原生視覺支援。
兩款模型都支援長上下文嗎?
是。DeepSeek 目前為兩個路由記載 100 萬 token 的上下文視窗。應在 ApiSmart 目前的模型目錄中確認。
V4.1 Flash 比 V4 Pro 便宜嗎?
DeepSeek 官方 API 費率表顯示,V4.1 Flash 的快取命中輸入、快取未命中輸入及輸出費率都較低。ApiSmart 價格可能不同,因此計算正式環境成本前,請查看即時模型清單。
應該立即替換 V4 Pro 嗎?
不應在未經測試的情況下立即替換。請讓兩款模型處理具代表性的提示詞、結構化輸出及工具工作流程。API 格式相容不保證行為完全相同。
哪一款模型更適合程式設計代理?
V4.1 Flash 通常是更好的候選模型,因為它在儲存庫、終端機及自動化評估中表現出色,同時具備較高的服務效率。
可以透過 ApiSmart 使用兩款模型嗎?
ApiSmart 透過統一平台提供 DeepSeek 模型路由。請在目前的後台確認可用性、確切模型識別碼、後端版本、價格及支援參數。